在用戶規模指數級增長、數據形態日益復雜的時代,小米作為全球領先的智能硬件與互聯網服務公司,其業務生態產生了海量、多維、實時與離線并存的異構數據。為高效、穩定、智能地挖掘數據價值,賦能業務決策與用戶體驗提升,小米構建了名為“數據工場”的集中化、平臺化數據處理體系。其技術架構與數據處理服務的設計,核心圍繞高擴展、高可靠、低成本、易用性四大原則展開。
一、 分層解耦的技術架構
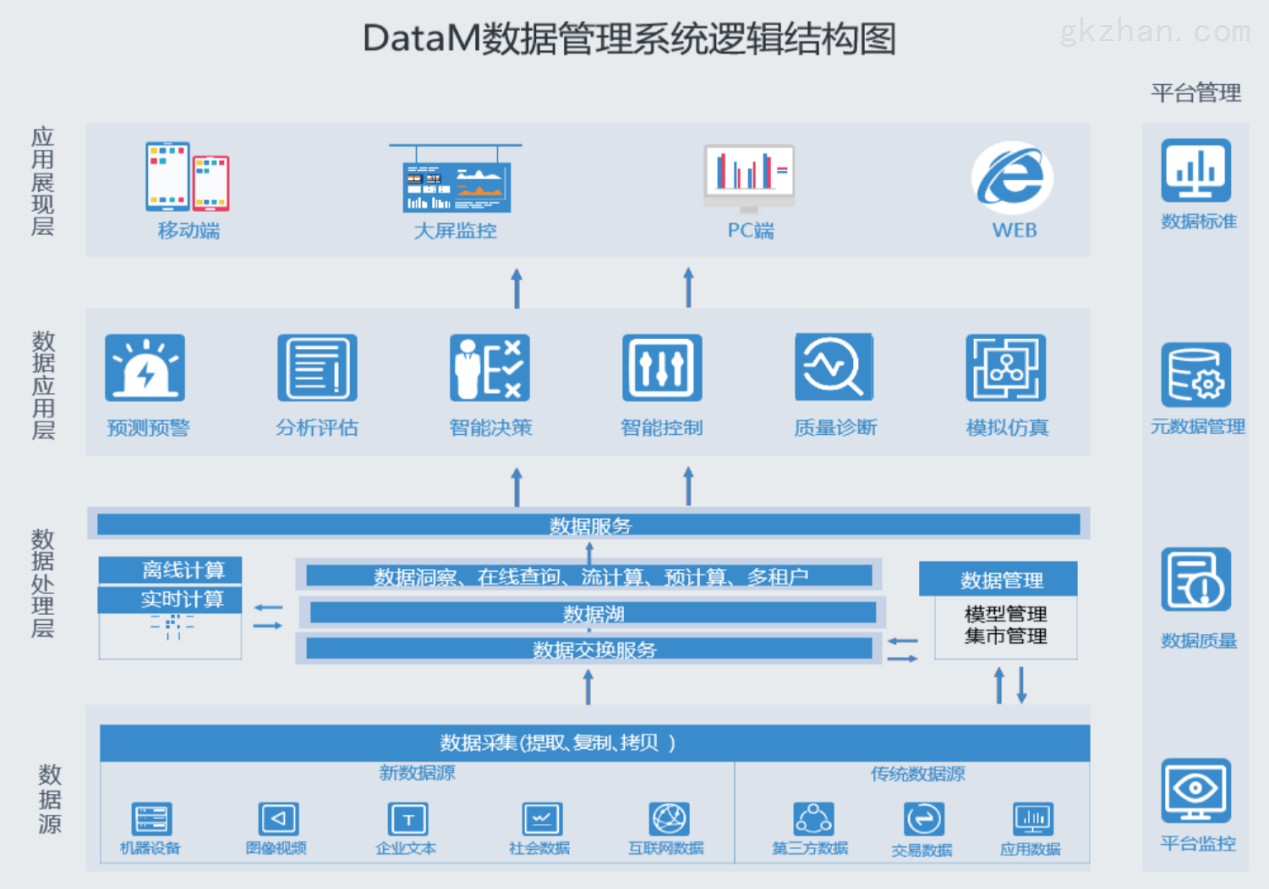
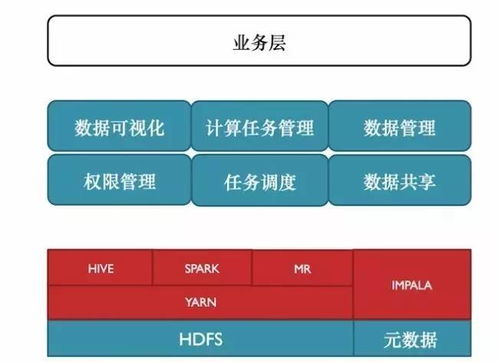
小米數據工場采用典型的分層架構設計,自下而上分為:
- 統一數據存儲層:
- 核心組件:基于HDFS、對象存儲、Kafka等構建混合存儲池。對離線數據、實時流數據、非結構化數據等進行統一納管。
- 關鍵設計:實行數據湖倉一體策略。原始數據以低成本方式入湖,保存全量細節;通過分層建模(ODS->DWD->DWS->ADS),構建主題清晰、易于分析的數據倉庫,兼顧靈活性與性能。
- 彈性計算與調度層:
- 計算引擎:根據場景選用不同引擎。離線批量處理采用Spark、MapReduce;實時流處理采用Flink;交互式查詢采用Presto/Trino;機器學習任務則集成TensorFlow、PyTorch等框架。
- 資源調度:基于YARN或Kubernetes實現統一的資源管理與調度,支持計算任務的彈性伸縮,有效應對業務高峰,并提升集群資源利用率。
- 工作流調度:使用Apache Airflow或自研調度系統,以DAG(有向無環圖)形式編排復雜的數據處理管道,確保任務依賴清晰、執行有序、故障可回溯。
- 數據開發與管理層:
- 一體化開發平臺:提供Web化的IDE,支持SQL、Python、Scala等多種語言進行數據開發,內置任務調試、版本管理、血緣分析等功能,降低數據開發門檻。
- 元數據與數據治理:構建統一的元數據中心,自動采集數據表、字段、血緣、生命周期等信息。通過數據地圖、數據質量監控(如完整性、準確性校驗)、數據安全分級與脫敏,實現數據的可知、可信、可控。
- 統一服務與API層:
- 將處理后的數據,通過統一的數據服務總線,以API、消息、數據文件等多種形式,安全、高效地分發給下游的報表系統、推薦系統、風控系統等業務應用。
二、 核心數據處理服務
基于上述架構,小米數據工場提供了一系列關鍵的數據處理服務:
- 實時數據流處理服務:
- 場景:用戶行為實時追蹤、APP實時監控、實時風控、實時推薦等。
- 實現:通過Flink消費Kafka中的實時數據流,進行窗口聚合、復雜事件處理、實時特征計算等,結果寫入OLAP引擎(如ClickHouse、Druid)或在線數據庫,供業務方低延遲查詢。
- 離線大數據處理服務:
- 場景:海量日志分析、用戶畫像構建、經營分析報表、模型訓練數據準備等。
- 實現:利用Spark進行大規模ETL(抽取、轉換、加載),執行復雜的多表關聯、聚合運算,按主題域構建數據模型,產出T+1或小時級的分析數據。
- 數據集成與同步服務:
- 功能:支持從MySQL、PostgreSQL等OLTP數據庫,通過CDC(變更數據捕獲)技術實時同步數據至數據湖;也支持將處理結果同步回業務數據庫或各類數據存儲。工具如DataX、Canal、Debezium被廣泛集成。
- 機器學習平臺服務:
- 一體化流程:在數據工場內集成特征工程、模型訓練、在線推理服務。數據科學家可以直接使用平臺處理好的特征數據,通過Notebook或拖拽式界面進行模型開發,并一鍵部署為在線服務,形成從數據到智能的閉環。
- 數據質量與運維服務:
- 全鏈路監控:對數據任務的計算耗時、資源消耗、數據產出時效、數據質量指標進行全方位監控與告警。
- 智能運維:基于歷史數據預測任務運行時間,自動優化資源分配;對失敗任務進行根因分析與智能重試,保障數據產出的SLA。
三、 面向未來的演進方向
面對持續增長的數據挑戰,小米數據工場正朝著更智能、更自治的方向演進:
- 智能化:引入AI技術優化自身,如通過強化學習動態調整調度策略,利用算法自動優化數據分布與存儲格式,實現基于成本的自動化優化。
- Serverless化:向用戶提供更抽象的數據處理服務,屏蔽底層基礎設施的復雜性,讓開發者更專注于業務邏輯。
- 實時化深化:進一步融合流批處理能力,推廣實時數倉和實時特征平臺,滿足業務對數據時效性日益苛刻的需求。
小米數據工場通過分層解耦、引擎多元、平臺化服務化的架構設計,構建了一個能夠支撐億級用戶、PB級數據、多業務場景的穩健數據處理體系。它不僅是大數據技術的集合,更是將數據作為核心生產要素,系統性賦能小米全生態業務創新的重要基礎設施。