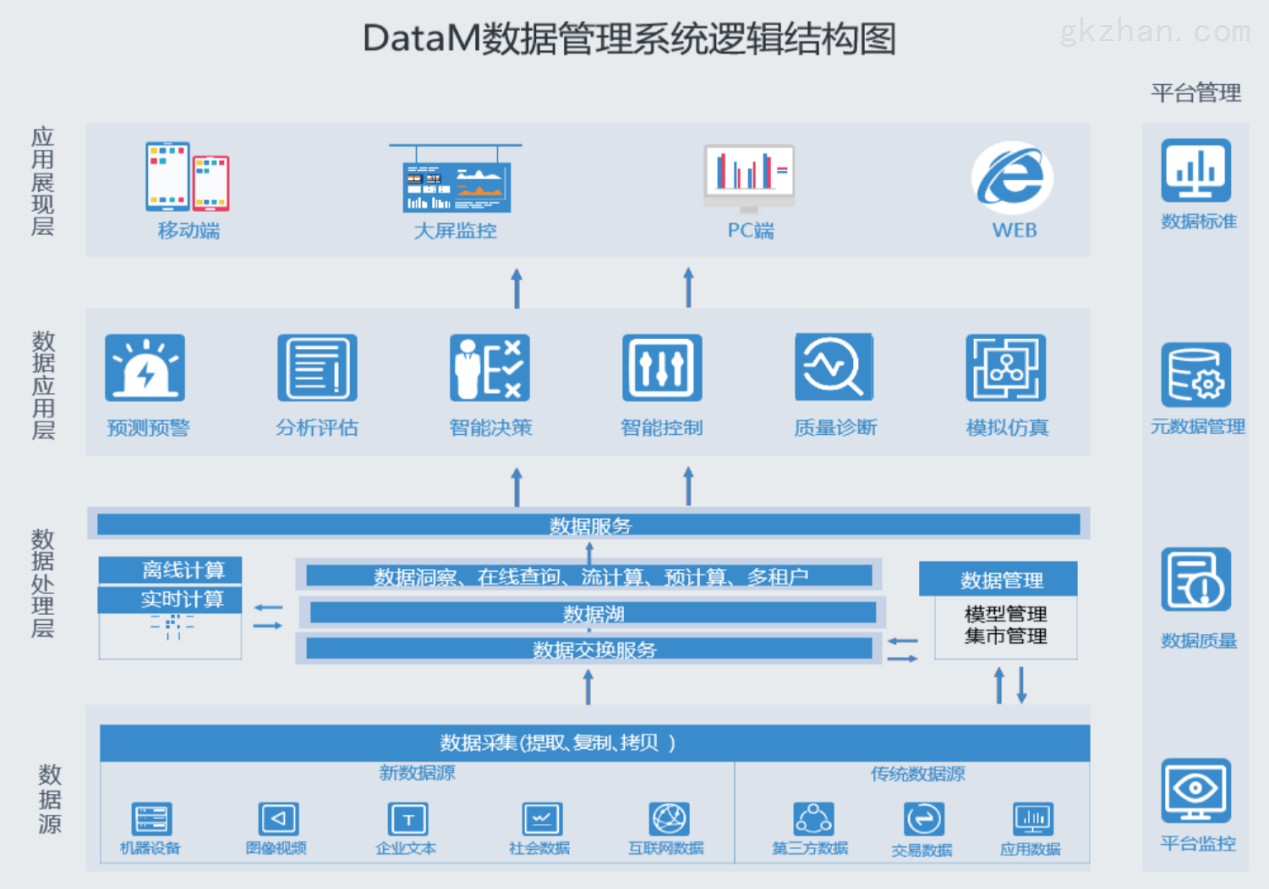
在智能運維(AIOps)場景下,大數據處理是實現故障預測、異常檢測和根因分析等核心能力的基礎。在分布式計算框架(如Spark、Flink)中處理海量運維數據時,數據傾斜(Data Skew)是一個常見且棘手的問題。數據傾斜指的是在分布式處理過程中,數據或計算負載在多個任務(Task)或分區(Partition)間分配極度不均,導致少數任務負載過重,成為整個作業的性能瓶頸,嚴重時甚至引發內存溢出(OOM)和作業失敗。
數據傾斜通常表現為:
- 個別任務執行時間異常漫長,遠超其他任務。
- 大部分任務很快完成,但整個作業需要等待少數幾個“拖后腿”的任務。
- 在Spark等框架的監控UI中,可以觀察到Stage內任務處理的數據量或記錄數存在巨大差異。
數據傾斜的成因
在運維數據處理中,傾斜通常源于數據本身的分布特性:
- 鍵值分布不均:在進行
join、groupBy、reduceByKey等聚合操作時,某些鍵(Key)對應的數據量異常龐大。例如,在按“主機名”或“服務ID”分組統計錯誤日志時,某個故障服務的日志量可能占總量的大部分。 - 數據源分區不均:源頭數據(如Kafka topic的partition、HDFS文件塊)本身就分布不均勻。
- 業務數據熱點:如全公司的網絡流量都經過某幾個核心交換機,或者某幾個關鍵業務模塊產生的指標數據量遠超其他模塊。
針對性的解決方案
解決數據傾斜需要從數據、業務和計算框架等多個層面綜合施策。
- 預處理與過濾:
- 熱點數據分離:識別并分離出導致傾斜的“熱點Key”。可以對這些熱點數據(如某個核心服務的日志)進行單獨處理,例如用一個獨立的作業先行聚合,再與正常數據的結果進行合并。
- 無效數據過濾:在業務允許的前提下,過濾掉一些無意義的、量大的中間數據或調試日志,從源頭減少數據量。
- 調整任務并行度與分區策略:
- 提高Shuffle并行度:通過設置
spark.sql.shuffle.partitions(Spark SQL)或reduceByKey的numPartitions參數,增加Shuffle后的分區數量,讓負載更分散。但這對于存在極端熱點Key的情況效果有限。
- 自定義分區器:實現自定義的Partitioner,將熱點Key打散到多個不同的分區中,避免單個分區承載過多數據。例如,可以將原始Key加上隨機前綴(如
hotkey<em>1,hotkey</em>2),先進行聚合,最后再去掉前綴進行二次聚合。
- 優化Shuffle操作:
- 使用Map端聚合:在Shuffle前,盡可能使用
combineByKey、reduceByKey等帶有預聚合(Combine)功能的算子,減少Shuffle傳輸的數據量。
- 將Reduce側Join轉為Map側Join:當一張表較小時,使用
broadcast(廣播變量)將其分發到所有計算節點,將Reduce Join轉換為Map端的本地查找,徹底避免由大表關聯引起的Shuffle傾斜。這是解決Join傾斜最有效的手段之一。
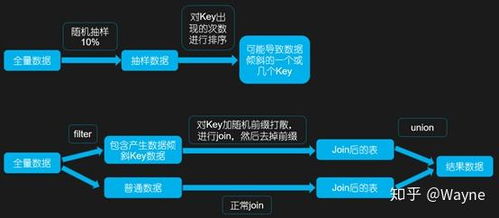
- 傾斜Join優化:對于無法廣播的大表Join,可采用“拆分傾斜Key”的策略。識別出大表中的傾斜Key,將其單獨取出,與另一張小表(或該Key對應的另一張表的分片)進行廣播Join,而將剩余的正常數據進行普通的Shuffle Join,最后合并結果。Spark 3.0+ 的AQE(自適應查詢執行)可以自動檢測并在一定條件下處理傾斜Join。
- 利用框架高級特性:
- 啟用Spark AQE:在Spark 3.0及以上版本,啟用自適應查詢執行(
spark.sql.adaptive.enabled=true),AQE可以動態合并小的分區、拆分傾斜的分區,并在運行時優化Join策略,對緩解數據傾斜有顯著效果。
- 增加資源與調整配置:為可能承載熱點數據的分區任務分配更多資源(如Executor內存)。調整
spark.sql.adaptive.skewJoin.skewedPartitionFactor等參數,讓框架更敏感地識別傾斜。
- 業務與數據模型優化:
- 設計更均勻的Key:在數據采集或ETL階段,考慮設計更分散的聚合維度。例如,將“分鐘級時間戳”作為Key可能造成每分鐘一個熱點,可考慮與“機器ID”等組合成復合Key。
- 數據采樣與預分析:在處理前對數據進行采樣分析,了解數據分布,提前預判傾斜風險并制定策略。
****
處理智能運維場景下的數據傾斜問題,沒有一勞永逸的銀彈。關鍵在于監控中發現傾斜跡象,并結合具體業務邏輯分析成因。解決方案通常是從最簡單的增加并行度開始,逐步升級到分離熱點、優化Join、利用AQE等高級策略。一個優秀的智能運維數據處理服務,應當將數據傾斜的預防、檢測和緩解機制內嵌到其處理流水線中,通過動態配置和自動化策略,保障大規模運維數據分析任務的穩定與高效執行。